
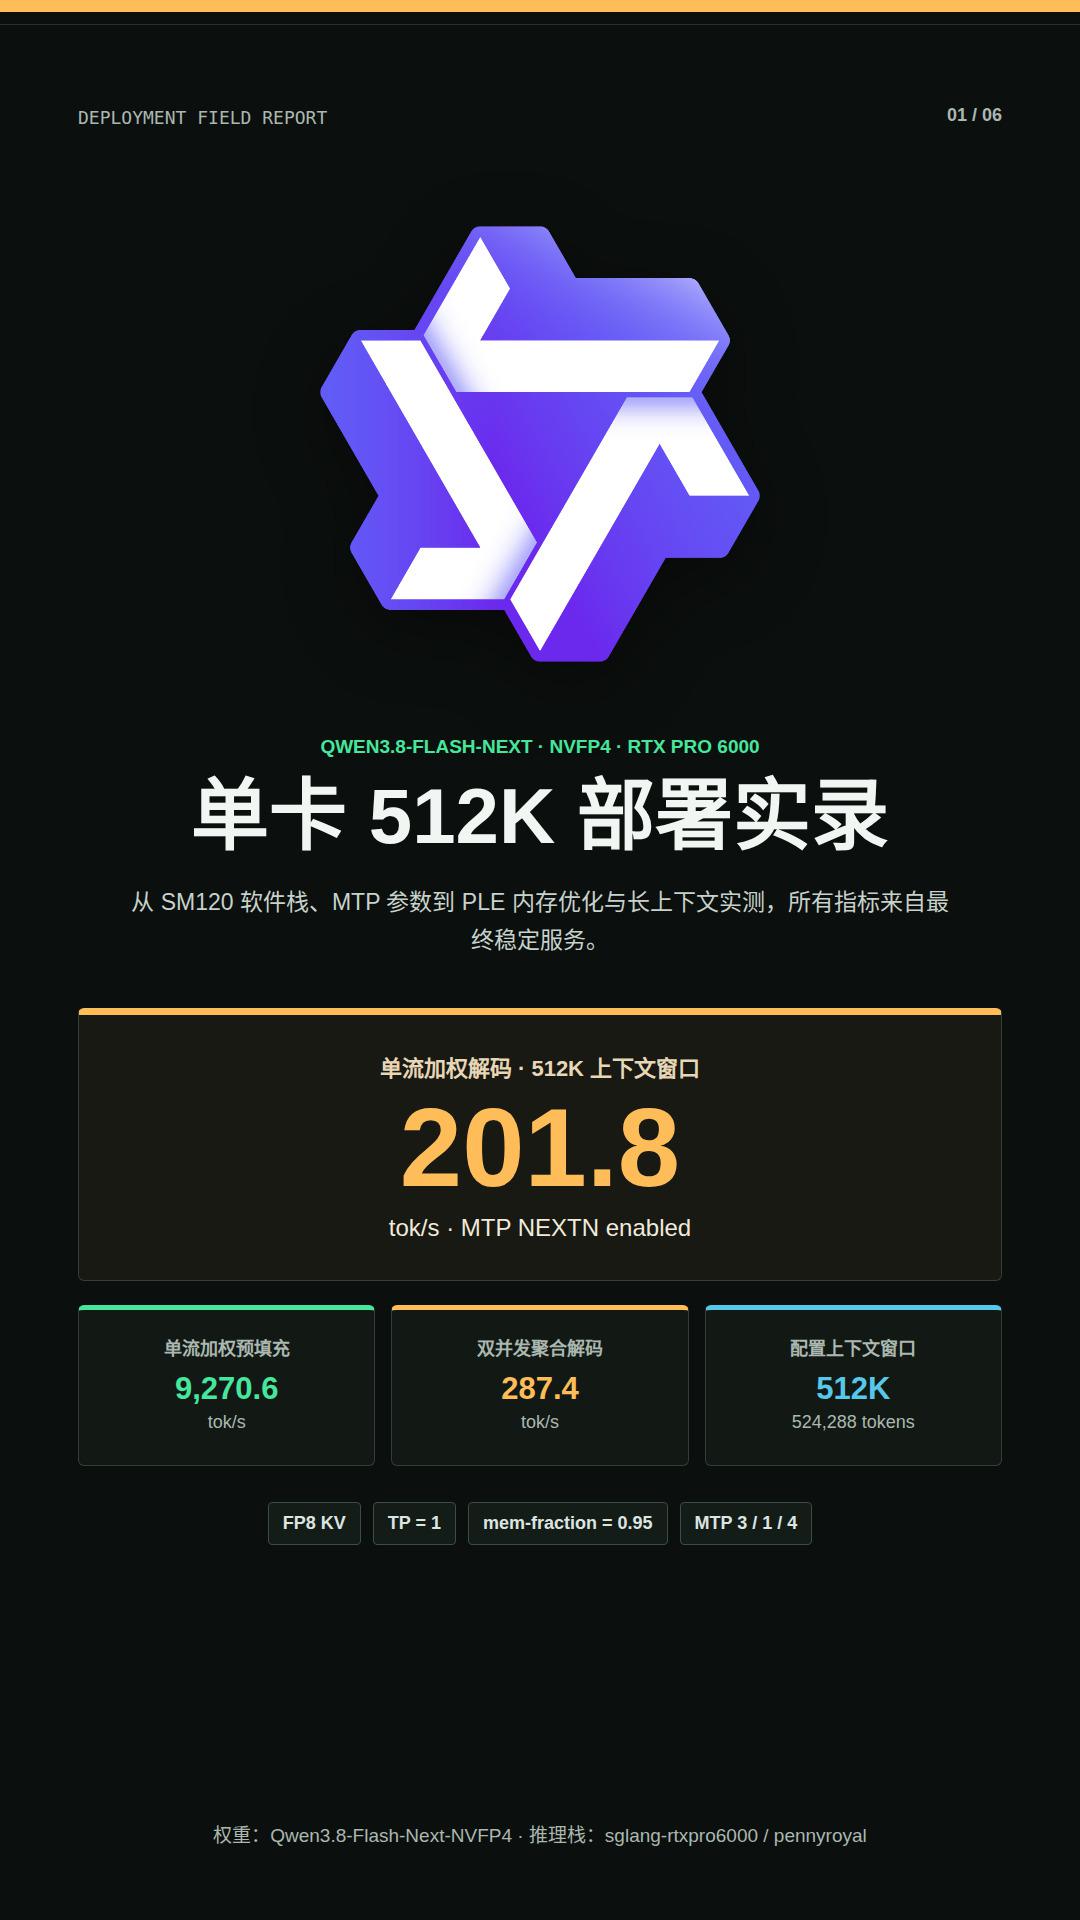
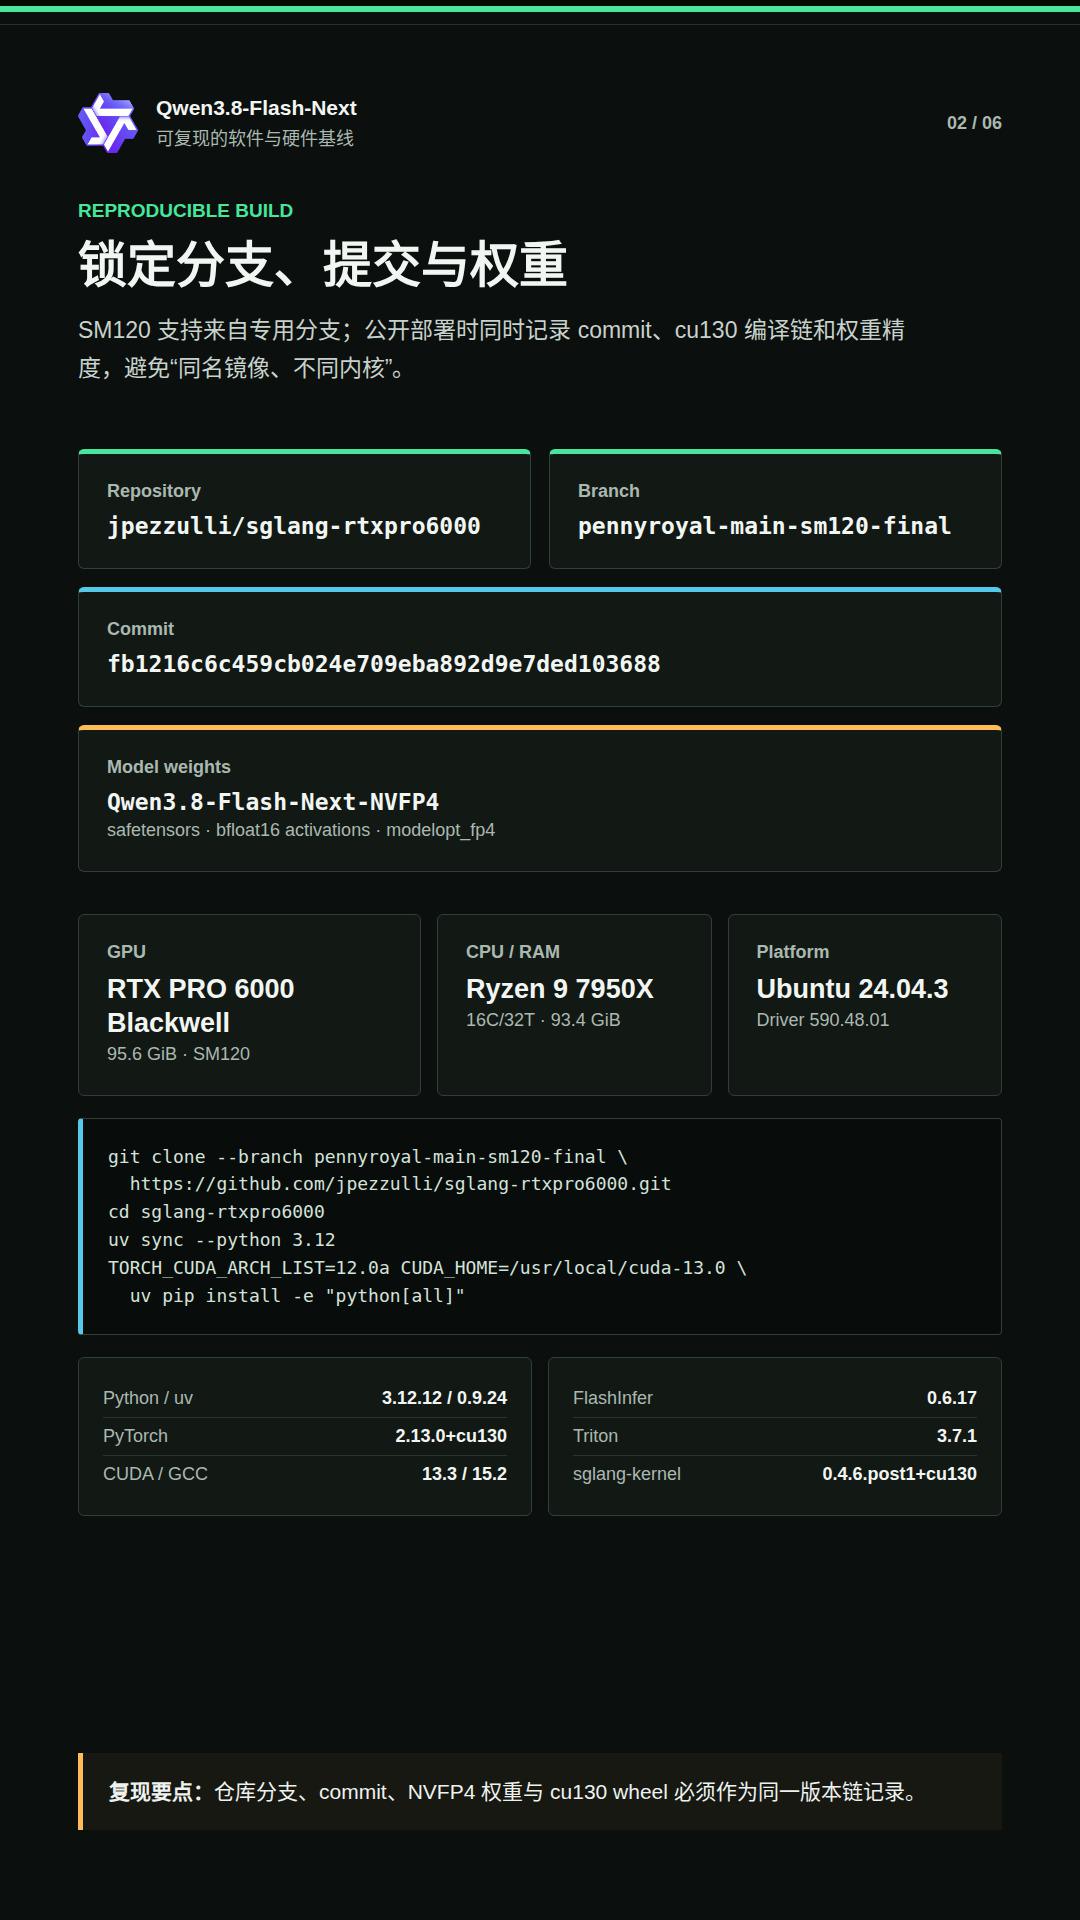
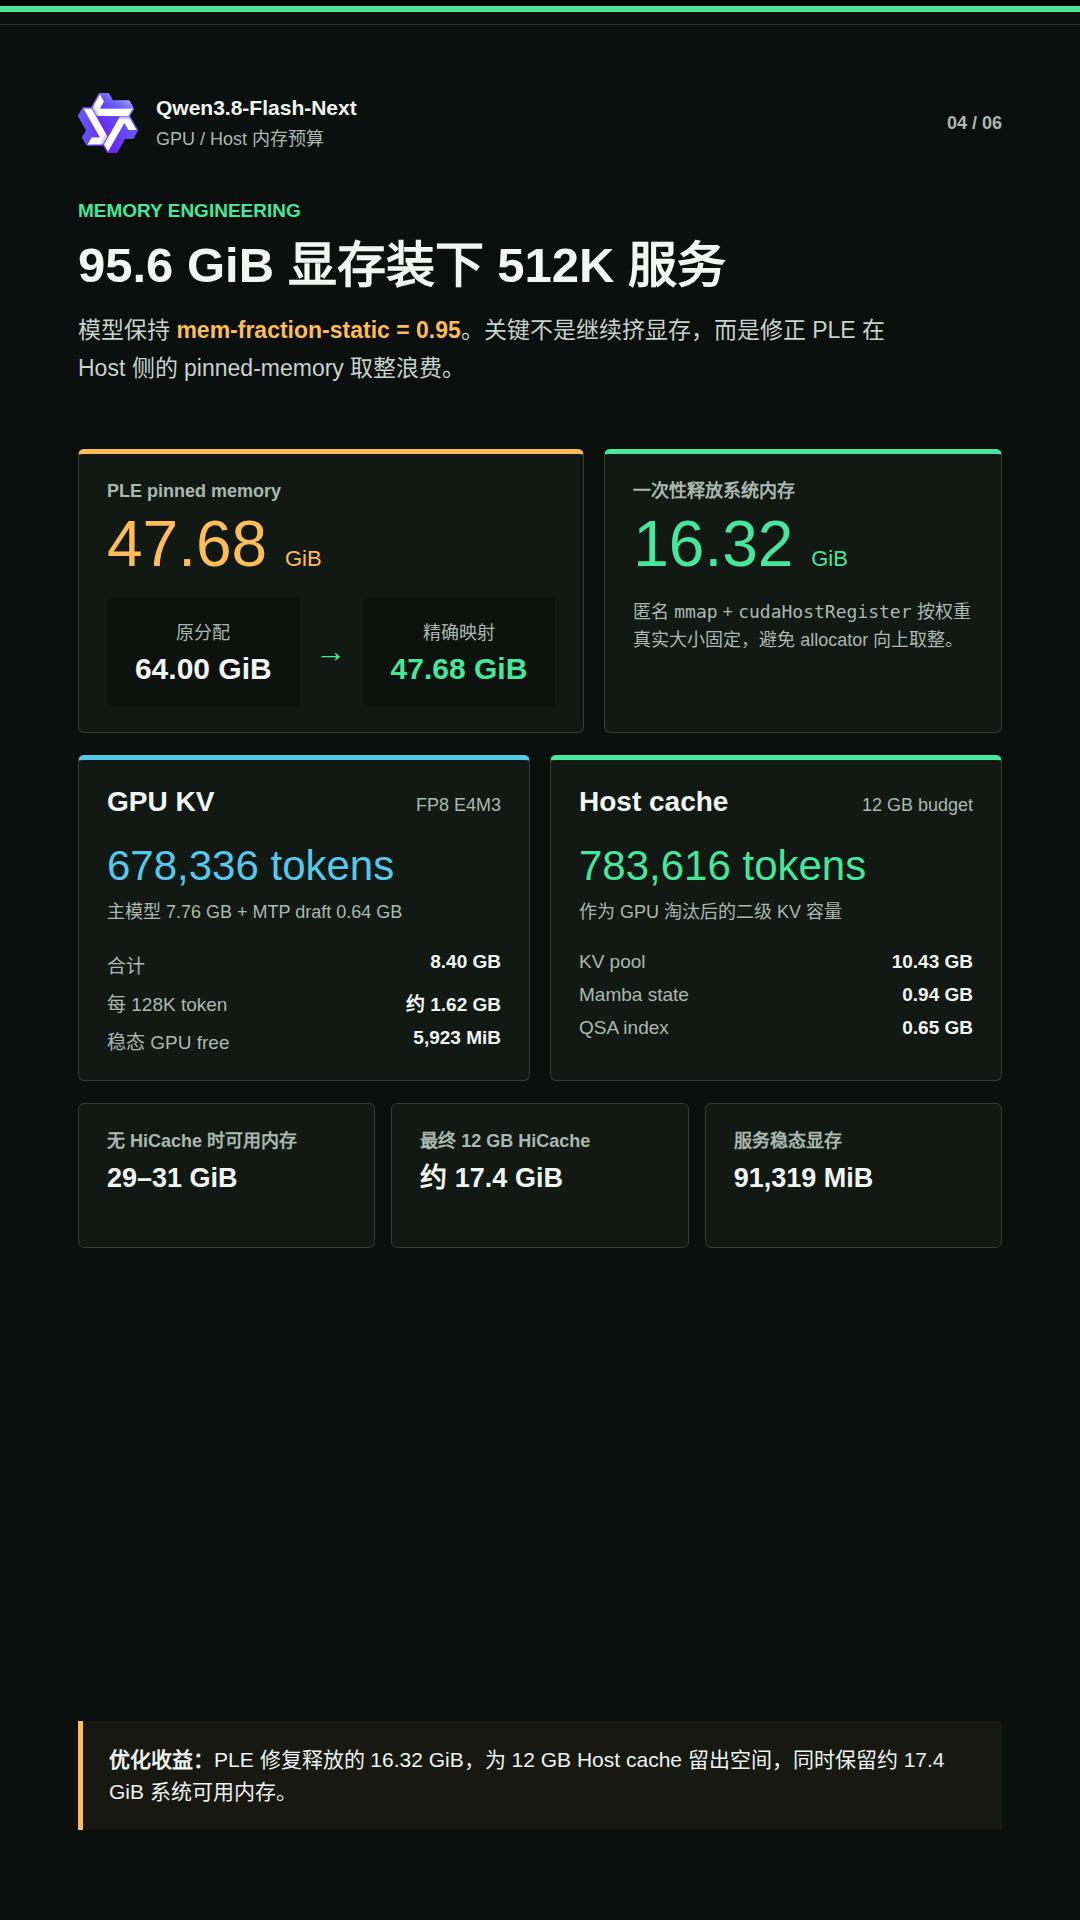
速度飞快,智力够用,十分好用,唯一的问题是占用了 60G 内存和 92G 显存,影响跑 ocr tts 和 asr 。
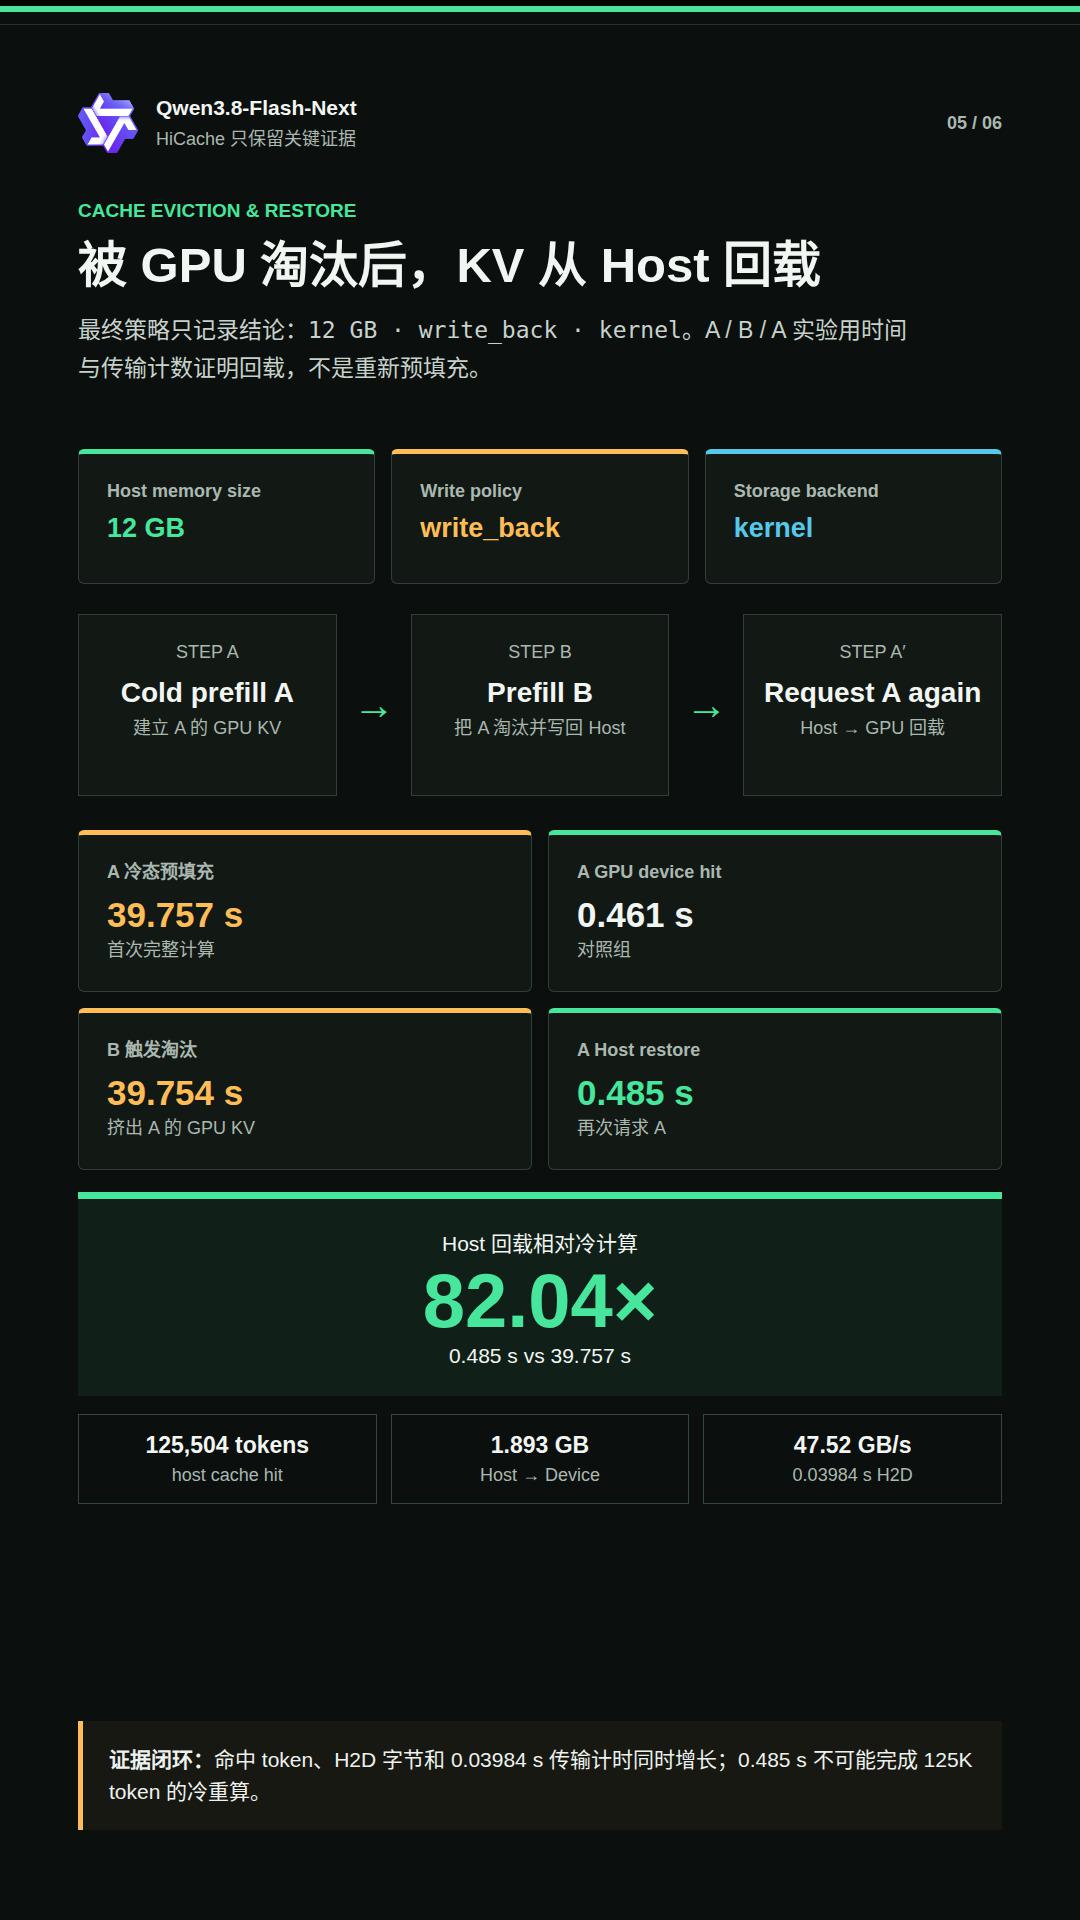
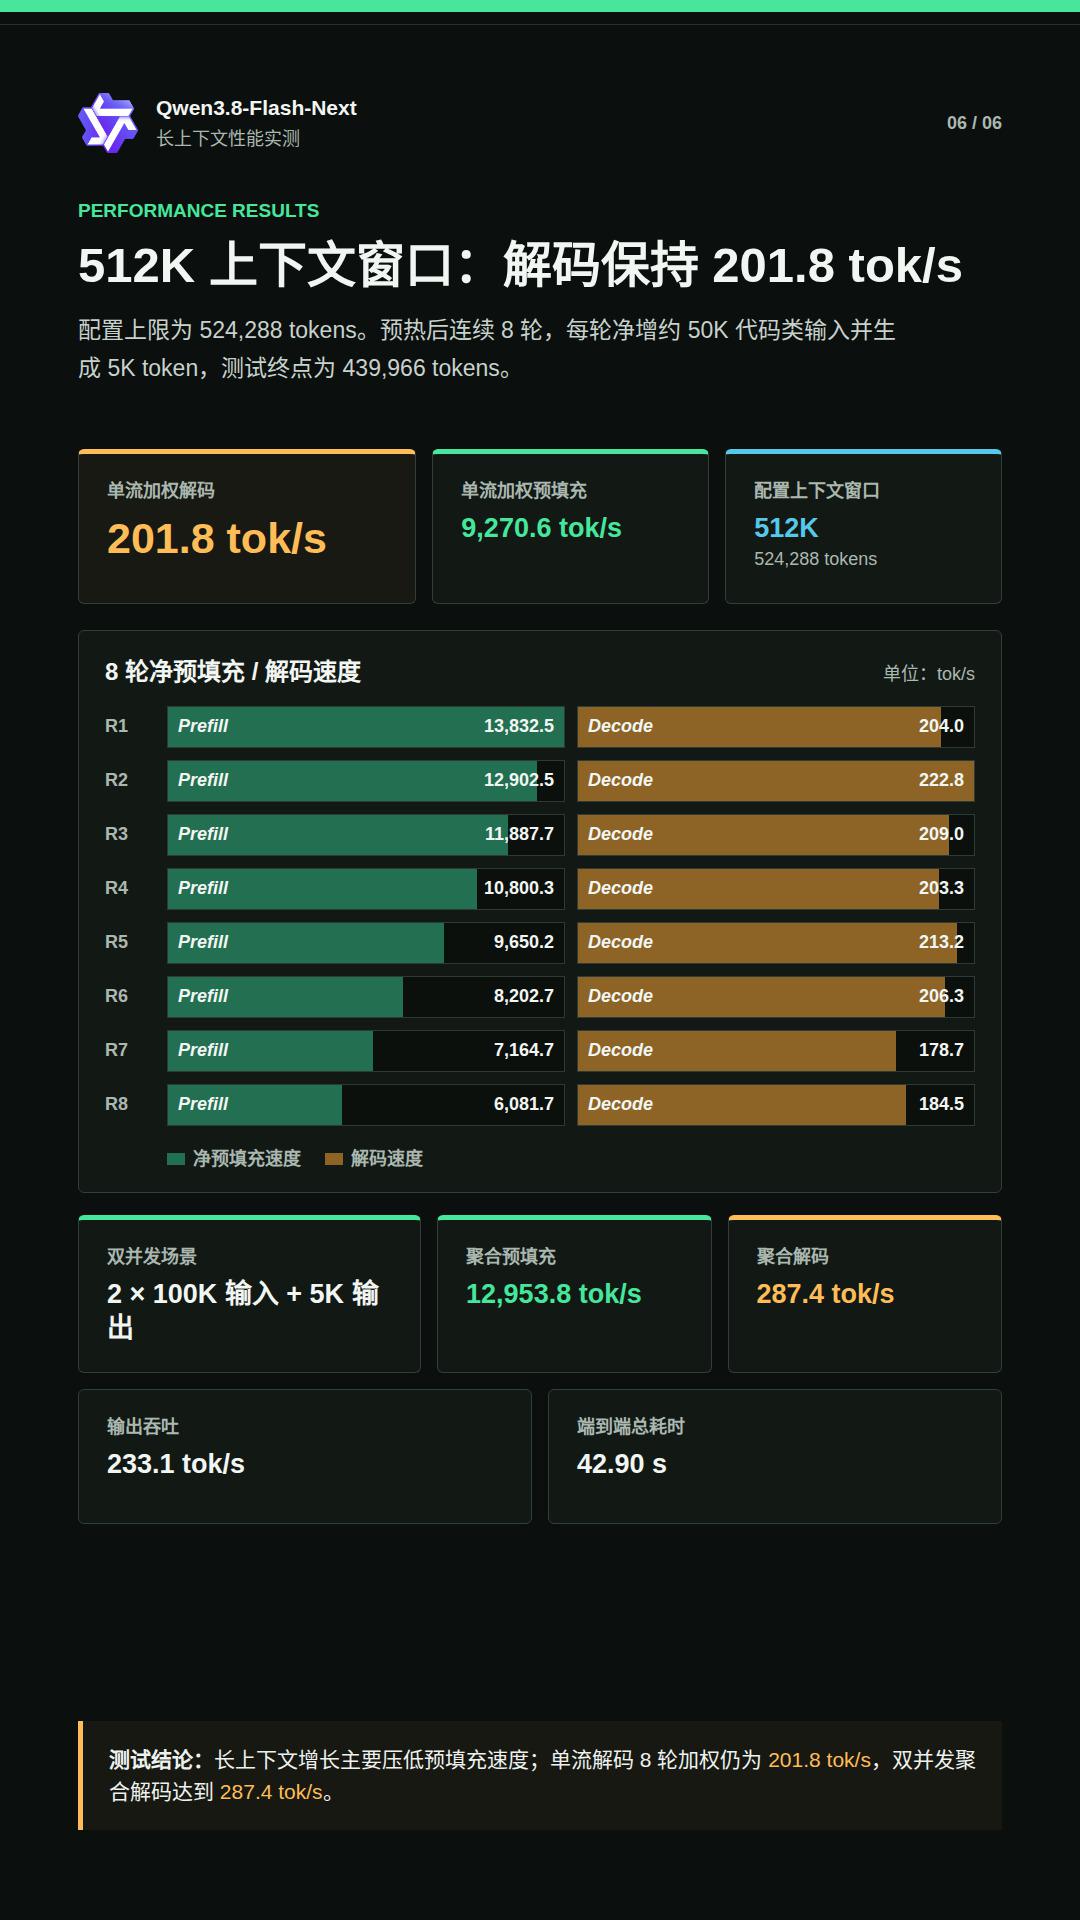
用了 12 年 V2EX 今天刚知道传一张图居然要收 20 币...


用了 12 年 V2EX 今天刚知道传一张图居然要收 20 币...
 |
1
JasonYip Sep 3
好羡慕 现在这个卡好贵啊 token 自由了
|
 |
2
piapia Sep 3 via iPhone
这卡年初才 6w 多吧
|
 |
3
kekxv Sep 3 via iPhone
ocr 直接让 qwen 识别按照格式返回就好了啊
|
 |
4
SiWXie Sep 3 via iPhone
羡慕,好奇能部署 glm 5.3 flash 吗?
|
 |
5
honjow Sep 3
羡慕死了
|
 |
8
marvin520 Sep 3
羡慕 token 自由
|
 |
9
coefu Sep 3
|
|
11
coefu Sep 3  2 蟹,bro 。
老师傅给你们一个便宜方案,有点 hack 。 找个 双 pcie 主板,最好能四通道,2*v100 32G ,m.2 16G 傲腾 M10 ,64G mem 。 1w 以内的解决方案。 绝招:装 Linux ,把傲腾 m10 映射成 vram cache ,v100 支持 GPUDirect Storage ,可以走 pcie 直接 读傲腾,绕过 cpu/mem 搬运。pcie3.0x16 30GB/s ,傲腾 16GB 容量。因为 傲腾夸张的 4k 随机读写和 mem 一个性能,所以,可以把 kvcache ( Q8 量化,1M context ) offload 到 M10 。engram offload 到 mem ,64G vram 放模型权重。 挤一挤,也能用。😂 |
 |
16
xiaomushen Sep 3
500K 上下文是甜点,Qwen3.8-Flash 智力足够
这个真心羡慕了,token 自由 |
 |
17
c0xt30a Sep 3
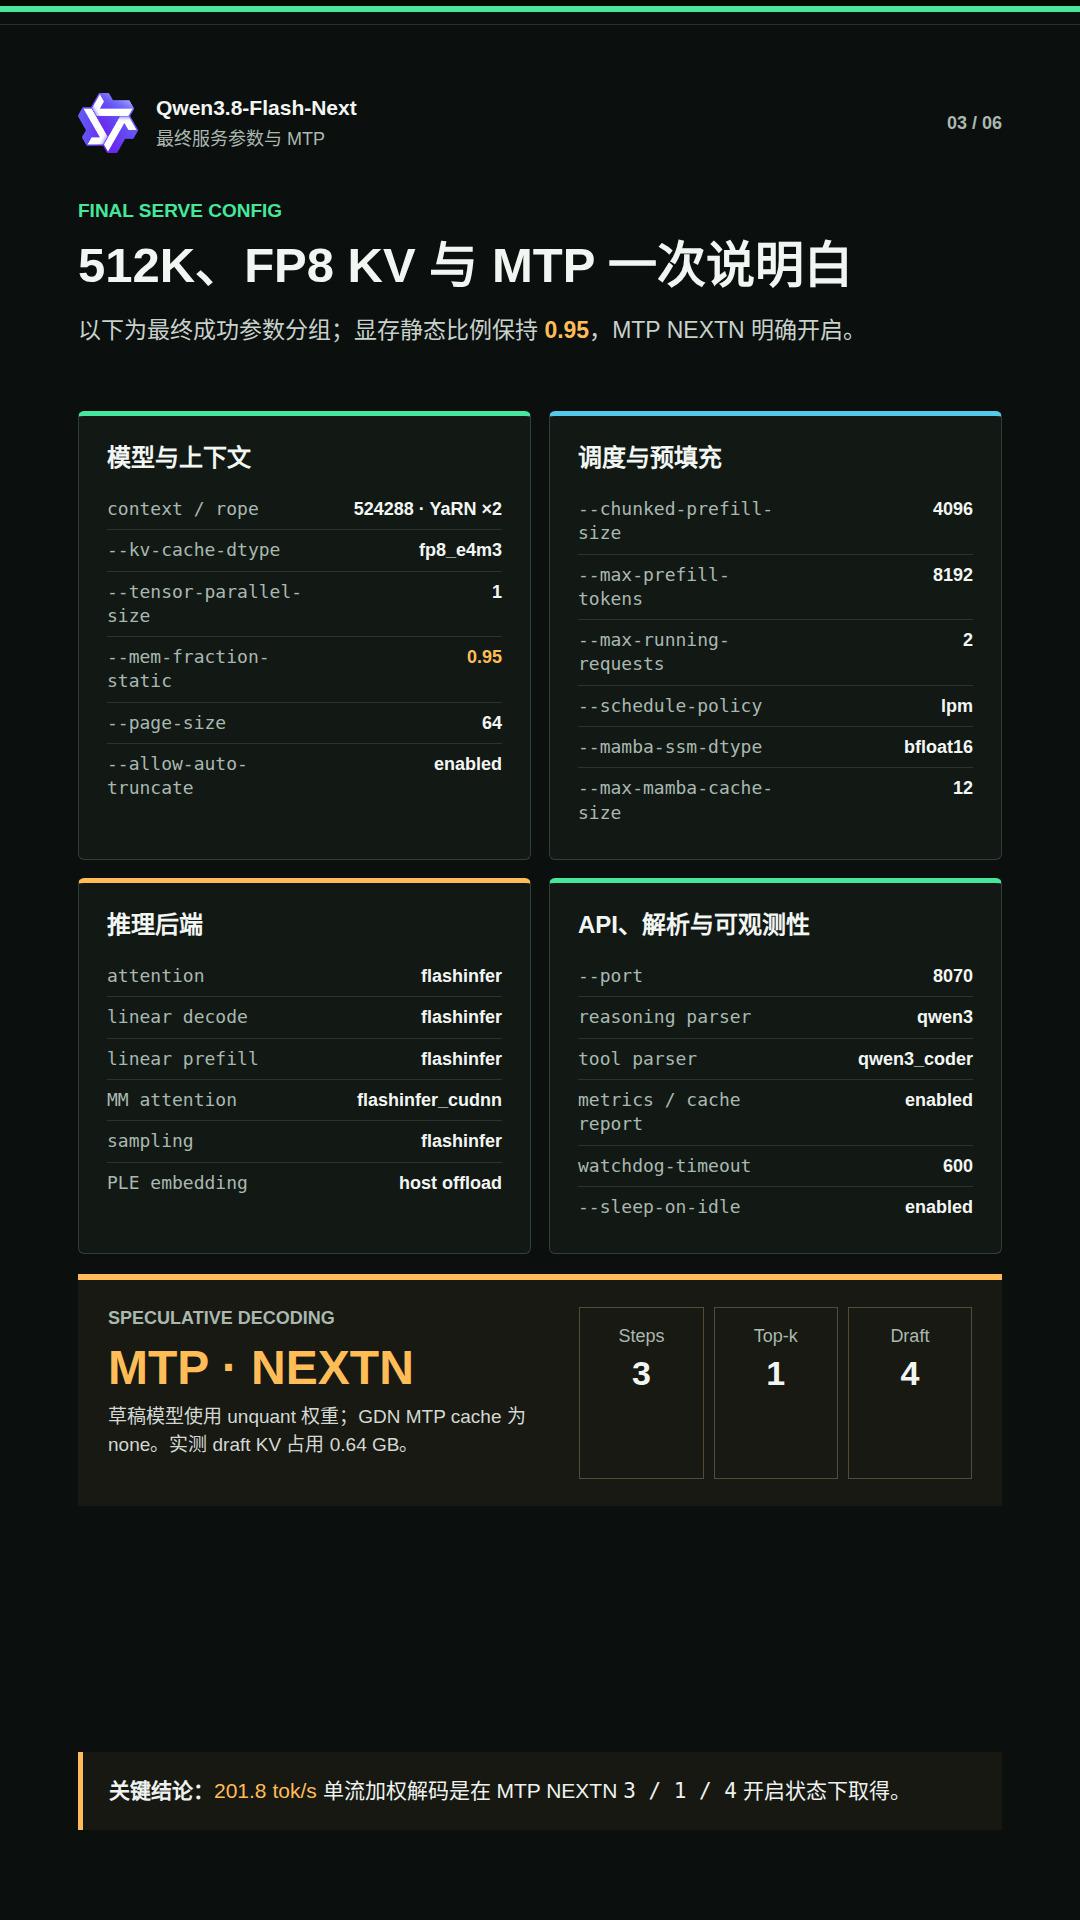
OP 是怎么设置 `partial_rotary_factor` 和 `factor` 到 512K ctx 的?
|
 |
18
catazshadow Sep 3
@coefu 这个有多少 prefill ?
|
|
19
coefu Sep 3
@catazshadow 这只是 idea ,我没去实践过,理论上看起来能跑通。
|
 |
20
zzutmebwd OP 1
@c0xt30a 当前 long 模式( systemd 默认跑的 serve-flash-next.sh )是这样设置的:
通过 SGLang 的 `--json-model-override-args` 覆盖到 `text_config.rope_parameters`: ```json {"text_config":{"rope_parameters":{ "mrope_interleaved":true, "mrope_section":[11,11,10], "rope_type":"yarn", "rope_theta":10000000, "partial_rotary_factor":0.25, "factor":2.0, "original_max_position_embeddings":262144 }}} ``` 配合命令行 `--context-length 524288`。 要点拆解: - `partial_rotary_factor=0.25` 是模型原生值(只有 25% 的 head dim 带 RoPE ,这个不是为扩长改的,只是随 override 一起显式声明,防止 SGLang 读不到 config 里的 rope 字段) - `factor=2.0` 是扩长手段:原生 `original_max_position_embeddings=262144`( 256K ),YaRN ×2 → 524288 ( 512K ) - `rope_theta=1e7`、`mrope_interleaved` + `mrope_section [11,11,10]` 保持不变,与原生配置一致 - 权重文件本身 config.json 里 rope 字段是空的( NVFP4 转换版没带),所以才需要 json-model-override-args 注入,两套脚本( serve-flash-next.sh / serve-flash-next-test.sh )里这段 override 相同 - fast 模式则不带这组 override ,直接用原生 256K 注意 factor 不是自己拍脑袋设的缩放率——262144×2.0=524288 ,与 `--context-length` 严格对应;两者不一致时 SGLang 会在 rope 外推区间外产生质量断崖。 |
|
21
zzutmebwd OP 1
@coefu 我认为至少需要一张 4090 48G 或者 dgx spark 128G 才能收获一个可用的速度(prefill > 1000 decode > 40) ,再低就没意义了,长程 agent 任务的单流输入输出量巨大,任务总时长会拉长到不可用的程度。我认为在智力达到一定程度后,速度更为重要。昨天一个论文审计任务的会话数据供您参考:
会话编号:20260903_204118_09742f 统计时间:2026 年 9 月 3 日 20 时 41 分 21 秒至 21 时 10 分 05 秒,总持续时间 28 分 44 秒。 该会话共完成 94 次模型调用,全部与 SGLang 请求日志成功匹配。累计处理输入 5,755,742 tokens ,其中缓存命中 5,359,296 tokens ,实际新增预填充 396,446 tokens ,缓存命中率 93.11%。 净新增上下文的加权预填充速度为 11,357.44 tok/s 。单请求预填充速度中位数为 7,560.8 tok/s ,P10 至 P90 范围为 2,335.6 至 12,391.9 tok/s 。短增量请求受固定调度开销影响,因此单请求中位数低于按新增 token 加权后的总体速度。 Hermes 记录的总生成量为 156,358 tokens ,SGLang 记录为 156,487 tokens ,两者差异来自结束符等特殊 token 。加权单请求解码速度为 159.21 tok/s ,单请求解码速度中位数为 162.0 tok/s ,P10 至 P90 范围为 141.8 至 218.3 tok/s 。 SGLang 调度批次的单流解码速度中位数为 153.3 tok/s 。期间只有 3 个双并发批次,双并发聚合解码中位数为 248.1 tok/s ,不适合作为该会话的主要性能口径。 MTP 投机解码的接受长度中位数为 2.5 ,P10 至 P90 范围为 2.0 至 3.2 ,非结构性代码任务 MTP 命中率明显偏低。请求排队时间中位数为 2.09 毫秒,P90 为 3.82 毫秒,最大 15.03 毫秒,未出现明显排队拥塞。 |
|
22
catazshadow Sep 4 via Android
@coefu 啊这😅
|
|
24
coefu Sep 7
@catazshadow 经过一段时间的深度使用之后,我还是回到了 muse glimmer 30B 。无他,qwen3.8 27B Q8 如果 kvcache Q8 ,在 10w context 的时候,decode 能掉到 2tok/s 以下,如果还开了推理,基本上就是没法用了。
muse glimmer 30B Q8 kvcache Q8 ,在 10w context 的时候,开了推理,decode 还能稳定在 10tok/s 。 牺牲一点性能,保持长 context 还能正常使用,如果 muse glimmer 深度上搞到 60+,后训练加强一点,以这个速度,就是这个领域的 top1 了。 |
|
25
catazshadow Sep 7
|
|
26
catazshadow Sep 7
@catazshadow 哦还有我用的是 AWQ
|
|
27
coefu Sep 7
@catazshadow 我设备不支持 vllm 。只有 llama.cpp 。开 MTP 一样。
你到 200k context 的时候 ,decode 还有多少?如果不用 Q8 的 kvcache ,最早的一些概念,估计它会忘记。 |
|
28
catazshadow Sep 7
@coefu 好像一直有 40 多吧,我 kv cache 用的 f16 ,哦,对了这个 vllm 是魔改过的能够在图灵卡上跑 flashinfer 的
|
 |
29
klc Sep 7
@coefu 为什么要用到 1M context ?别说本地的模型,云端的 GLM 、DSV4 聊到 200k context 我都觉得开始会出点小状况(可能是掺水模型吧),差不多了我会主动压缩上下文。
Qwen3.8 27B 有 Dflash2 ,显存吃紧可以找个 Q2 的 Dflash2 。猜得比 MTP 的接受率要高,是真能加点速。 掉到 2t/s 是爆显存 offroad 了吧,模型可以用其他量化再省点 VRAM ,只要不动 kvcache 问题不大。 |
|
32
coefu Sep 18
@catazshadow 彻底疯狂了,🤪。
https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF ,我推荐你用这个。 我的 64G umem 环境里,之前完全跑不动的 Q4 (首字 5min 才出来,0.5 tok/s )。 用了 llama.cpp 的 lazy 模式,首字 20s 不到,初始 20+ tok/s ,到 20w context 的时候还有 7 ~ 8 tok/s ,结果 llama.cpp 直接 context shift 了,同一个 slot 没有出现 context oom ,直接又从 9w 开始轮转,用上了 swap ,swap 蹭蹭涨,但是 tg 还有 10 tok/s 。 只能说 ,太屌了。 我之前 qwen3.8 27B 干的活儿,让 flash 找了好多 bug ,甚至很多深度 bug ,影响整个项目方向的 bug 都找得出来。 GPQA-D & scicode 的 benchmark 含金量是真的高,GPQA-D flash 比 27B 只高 2.5 分左右,能指导后者工作。GPQA-D 的 90 分,是个真正能力分水岭。27B 只有 89.2 ,flash 91.7 ,Fable 5 92.6 。这个 Q3 91.41 。 |
|
33
catazshadow Sep 18
@coefu 哈哈,我也来试试这个 flash next 。
这两天在折腾 llama.cpp 的 RPC 把两台机器连起来用。一共 96G 显存,能加载一些 Q4 120B 的 MoE 模型,Q8 的 kv 能开的 256K 。decode 速度一开始其实还是不错的,能有 20TPS 。就是 prefill 不好看,一开始有 400 多,到 100K context 的时候就只有 100 不到了。GPT OSS 120B 是最快的,不过这个现在好像已经比较傻了。后面试了 Laguna S 2.1 和 Mistral Small 3 ,都是能跑但太慢。这几个的回答感觉好像的确要比 27B 全面一点。 万兆网卡还在路上🤣 继续折腾估计就要上 PCIe 扩展板了😅 |
|
34
coefu Sep 18
|
|
35
catazshadow Sep 18
@coefu 我看到 LAN 上在 100K 上下文的时候能有 400Mbps 的通信,现在是千兆网,感觉上了万兆可能真的能用。。
|
 |
36
fcten Sep 20
年初的时候入了 PRO 6000 ,Qwen3.8-Flash-Next 发布后立马就用上了。体感上还是不错的,日常小需求完全不需要花费云端 token 了,平均 prefill 速度 12K/s ,decode 速度 130t/s 。
当初入这个卡的逻辑是:随着能力更强的开源模型不断发布,用于本地部署的硬件的价值会随之提升。现在基本也应证了这个观点:deepseek v4 flash 开源后,之前被非常不看好的 dgx spark 也香起来了。PRO 6000 和 5090 现在更都涨到天上去了。 |
|
37
catazshadow Sep 23
@coefu 加上万兆网卡的结果,一共 96G 显存,两台机器 4+2 张卡
qwen 系列的 prefill 感觉跟这种跑法有仇,开头就只有 160 多,直接放弃了。单机用 lazy 模式跑也不快,简直了。 laguna S 和 mistral small 都差不多,加载了个 110K 的会话历史,开始 prefill 在 480 左右,在 110K 的时候大概有 280 ,tg 的话能有 10 左右,感觉是垃圾佬的极限了,毕竟几千块跑起来这么大的模型。 |
|
38
coefu Sep 23
|
|
39
coefu Sep 23
@catazshadow 我也有个 6pcie 槽的大矿机,但是,电源是 3kw 的,电费搞不起。😂
|
|
40
catazshadow Sep 23
@coefu qwen 3.8 flash next ,就你上一条发的那个
电费算毛 hhh 。还有就是 layer split 其实每一时刻只有一张卡满载,总功率其实是(N - 1) 待机功率 + 1 x 满载功率,6 张卡也就 400W 来瓦顶天了,几千块搞定 Strix Halo 能干的活,要什么自行车🤣 |
|
41
coefu Sep 23
@catazshadow deepseek harness ,v 0.1.5 能主动压缩 context ,我在一个会话里 用 qwen3.8 flash next 干到 83 轮 652 步 还能 9.8 tok/s ,之前的 qwen3.8 27B 早就要掉到 0.x tok/s 了。
ISTA-DASLab 的压缩量化技术,确实屌。 希望 qwen4 能更上一层楼,之前我还喷 qwen ,😂,真是要自我掌嘴了。 |
|
42
catazshadow Sep 23
@coefu 还能这么玩。要配合 flash next 还是都可以?压缩了会变傻么?
|
|
43
coefu Sep 23
@catazshadow 我觉得这个是 dsh 的通用功能,实际上就是把本地 session 让模型自己搞一次压缩,压缩结果都是显式在 web 端可以看到的,然后占用一些当前会话的 agent prompt 。我也是昨天才更新了一下 dsh ,发现有这个压缩的过程。
我这个 context 都搞了几轮 262144 的 context ,太长了,傻不傻,我都没能力区分。反正过程最终有个最终目的 test 。 |
|
44
catazshadow Sep 23 via Android
@coefu 上下文压小了确实会快点,回头看看怎么搞
|
 |
45
oldlamp Sep 25
|
 |
47
jackOff Sep 28
大佬你这个和 deepseek v4 flash 比起来如何啊
|
 |
49
jinsongzhaocn 23h 29m ago
但是这个模型编程和 agent 居然没超过 27B
|
|
50
zzutmebwd OP @jinsongzhaocn 不知道你是哪里看到的没超过 27B ,astra 调研的结果是 Flash Next 编程略优、Agent 大幅领先、速度翻倍:
以下分数按 **27B / Flash-Next** 排列: - **智力**:AA 指数 34 / 40 ; Flash-Next 整体更强,普通推理、数学差距较小。 - **编程**:SWE-bench Pro 为 61.7 / 62.5 。 - **Agent**:Toolathlon 工具调用 67.1 / 73.5 。 - **长文**:AA-LCR 为 82%/ 80%,不足以证明普遍优势。 - **速度**:同硬件纯显存推理( RTX Pro 6000 96G ),Flash-Next NVFP4 预填充和解码速度较 27B NVFP4 快约一倍。 - **资源**:27B 内存需求明显更低。 |
|
51
jinsongzhaocn 1h 36m ago
@zzutmebwd 我在本机用 zx-brench 测试的,环境是 4090 24GB 。 唯独编程这个指标比同本机 27b 低了 10%左右
|

 Select Language